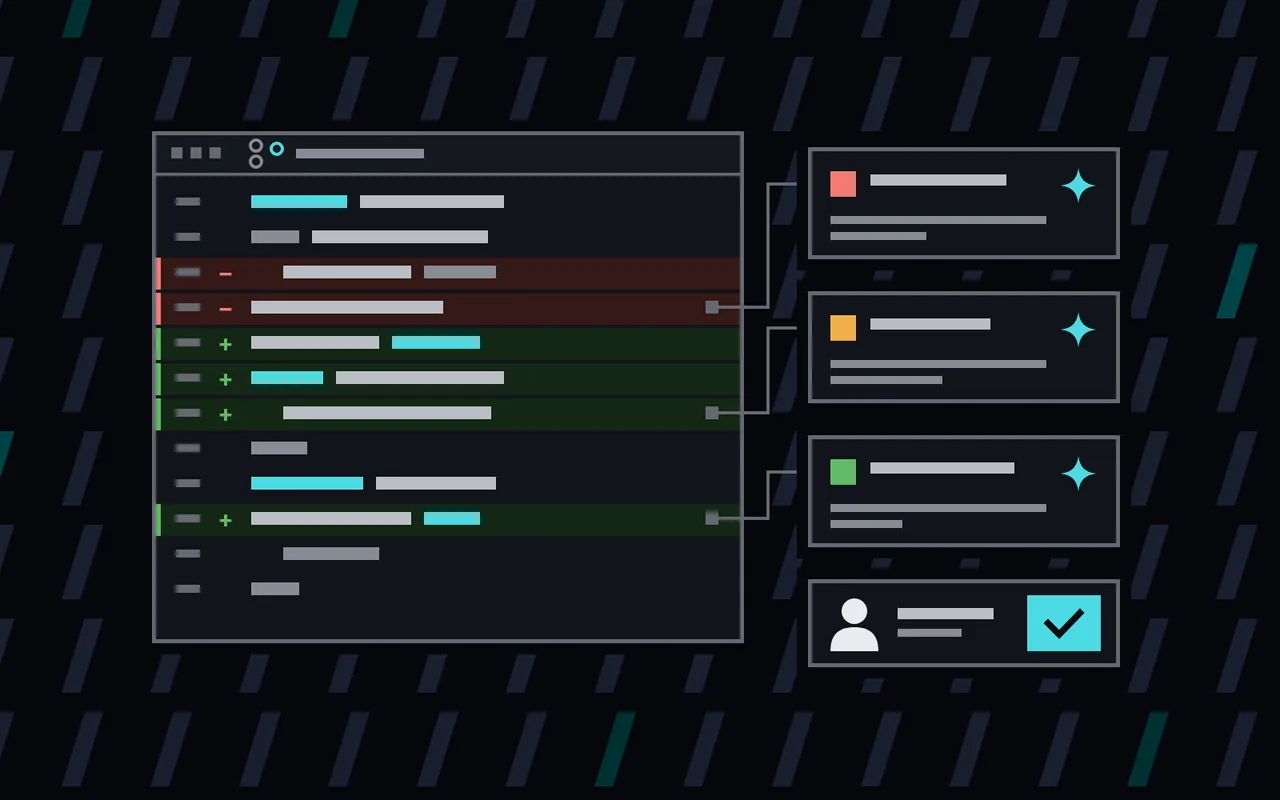
Mainlaneは、1人のエンジニアとAIエージェントのチームです。そこで当然の疑問が生まれます。AIが書いたコードは誰がチェックするのか?私たちの答えは、そのコードを書いていない別のAI、そしてリリースするかどうかを決める人間です。
ループ
- Claudeのセッションがタスクを受け取り、プルリクエストを作成します。
- 別のレビュアーがクリーンなセッションで起動します。コードがどう書かれたかを一切見ていないため、作成者の思い込みを持たずに、同僚と同じ目線でdiffを読みます。
- レビュアーは指摘を3段階で残します。🔴 必ず修正、🟡 修正すべき、🟢 あると良い。
- 作成者のセッションが修正し、1項目ずつ返信します。最後には「検証」セクションを付け、実行したコマンドとその出力を示します。
- レビュアーが新しいheadを確認します。指摘が1つもなくなるまで、🟢さえなくなるまで、ループを繰り返します。
ループを誠実に保つためのルールが2つあります。指摘に反論できるのは測定結果、つまり数値、コマンドの出力、テストが検出できないミュータントによってだけで、「問題ない」という言葉では反論できません。また、5ラウンドを超えるとループは止まって人間に判断を仰ぐので、永遠に回り続けることはありません。
人間の役割
エージェントはマージしません。レビューで指摘がなく、レビュアーが確認したまさにそのコミットでCIがグリーンになると、セッションは「マージ可能」と書いて待機します。マージは人間が承認した後にだけ、しかもそのコミットに対してだけ行われます。
何を見つけるのか
このWebサイトのリポジトリから、実際の例をいくつか紹介します。
- CIにLighthouseのチェックを追加したプルリクエストで、レビュアーはCSSのビルド設定が誤ったフォルダーを指していて、レイアウトのスタイルがサイトから静かに消えていることに気づきました。これはLighthouseもアクセシビリティチェッカーも検出していませんでした。さらに、固定表示の言語バナーがキーボード利用者のフォーカス中の要素を覆い隠しうることも見つけました。
- データベースバックアップの復元チェックでは、毎日のテストが復元したデータをエクスポートではなく自分自身と比較していて、欠けた行に気づけない状態でした。同じレビューで、見込み客のメールアドレスをログに出力しうるエラーメッセージも見つかりました。
- Content Security Policyの導入では、ブラウザー拡張機能からのレポートのせいで「違反ゼロの1週間」という目標が永遠に達成されず、ポリシーを強制した時点でブログ記事内の外部画像が表示されなくなるところでした。
どれも特殊なものではありません。疲れた人が金曜の夜に見落とすような類のものです。
数字で見る
2026年10月末時点で、このループは8つのリポジトリで動いており、マージされたプルリクエストは385件、レビューは1,069件です。コストの大部分は作業そのものです。10月の最終週には、トークンの約4分の3が実装に、10分の1未満がレビューに使われました。
限界
レビュアーは作成者と同じ種類のモデルなので、同じ死角を持つことがあります。重要な変更に対する人間のレビューの代わりにはなりません。また、プルリクエスト内のテキストは常にデータとして扱い、指示としては扱いません。その代わりに担うのは、ほとんどの個人開発者が省いてしまう工程、つまりすべての変更に対するもう一組の目です。