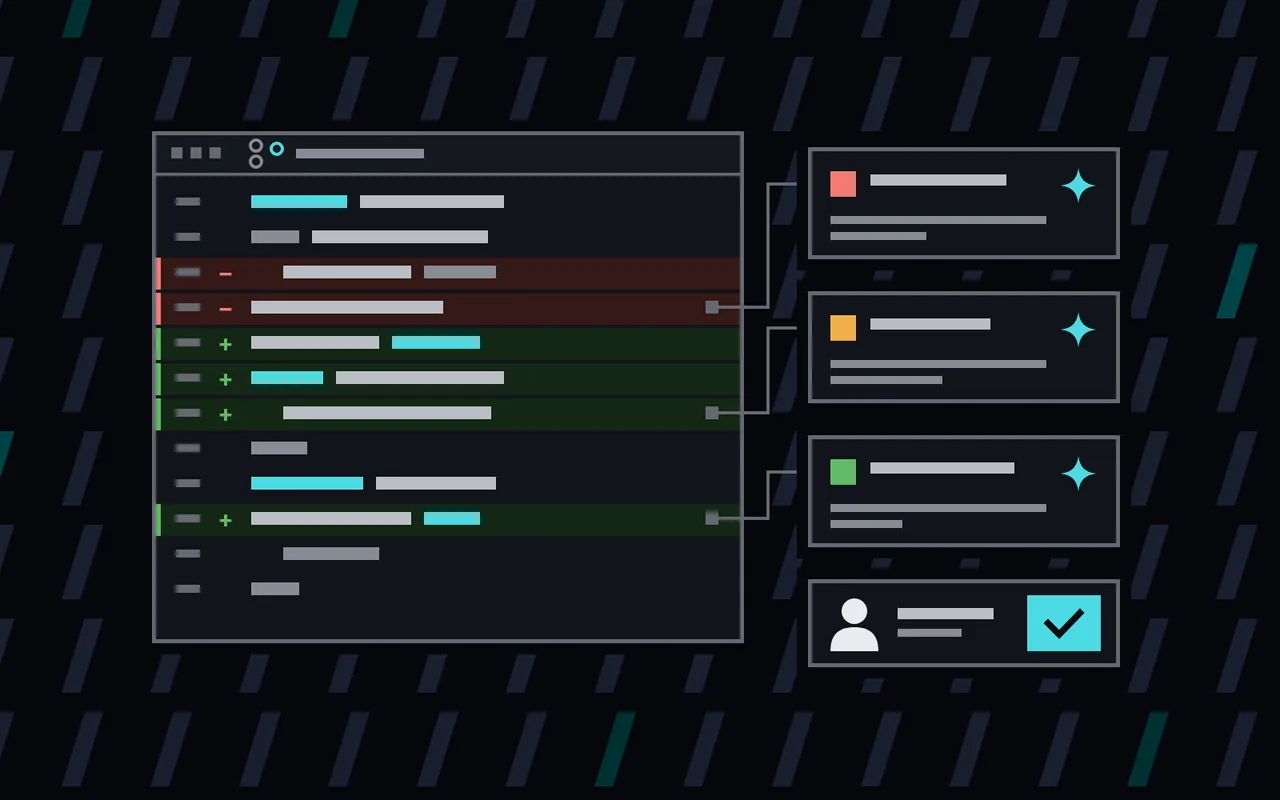
Mainlane由一位工程师和一支AI智能体团队组成。这自然引出一个问题:AI写的代码由谁来检查?我们的答案是:由另一个没有参与编写的AI审查,再由人来决定是否发布。
流程
- 一个Claude会话接手任务并发起拉取请求。
- 另一个审查者在全新的会话中启动。它从未见过代码是怎么写出来的,所以会像同事一样阅读diff,不带作者的预设。
- 审查者把发现的问题分为三级:🔴 必须修复,🟡 建议修复,🟢 锦上添花。
- 作者会话修复问题并逐条回复,最后附上“验证(Verification)”部分:列出运行过的命令及其输出。
- 审查者检查新的head。循环一直重复,直到没有任何问题为止,连🟢也没有。
有两条规则确保过程不走样。对某个问题提出异议,只能拿出测量结果,比如一个数字、一段命令输出、一个测试没能抓住的变异体,而不能只说“没问题”。另外,五轮之后循环会停下来请人决定,因此永远不会无休止地转下去。
人的环节
没有任何智能体执行合并。当审查没有问题,并且CI在审查者看到的那个提交上恰好通过时,会话会写下“ready to merge(可以合并)”然后等待。只有在人明确同意后才会合并,而且只合并同一个提交。
能发现什么
以下是本网站代码仓库中的几个真实例子:
- 在为CI添加Lighthouse检查的拉取请求中,审查者发现一项CSS构建设置指向了错误的文件夹,导致布局样式悄无声息地从网站上消失。Lighthouse和无障碍检查工具都没有发现这个问题。它还发现一个固定的语言横幅可能会遮住键盘用户当前聚焦的元素。
- 在数据库备份恢复检查中,每日测试把恢复后的数据和它自己比较,而不是和导出数据比较,即使丢了行也永远发现不了。同一次审查还发现一条错误信息可能会把潜在客户的电子邮件写进日志。
- 在推行Content Security Policy时,来自浏览器扩展的报告会让“一周无违规”的目标永远无法达成,而且一旦强制执行该策略,博客文章中的外部图片就会无法显示。
这些都不是什么罕见问题,而是周五傍晚疲惫时很容易漏掉的那类问题。
数据
截至2026年10月底,这个循环在8个代码仓库中运行,已合并385个拉取请求,完成1,069次审查。大部分成本花在工作本身:10月最后一周,约四分之三的token用于实现,用于审查的不到十分之一。
局限
审查者和作者是同类模型,因此可能有相同的盲点。它不能取代人对重要变更的审查,拉取请求中的文字一律被视为数据,而不是指令。它真正取代的是大多数独立开发者都会跳过的一步:让每一处变更都多一双眼睛把关。